Qu'est-ce que le RAG (Retrieval-Augmented Generation) ?
Le RAG est une architecture IA qui connecte les modèles de langage à des sources de données externes en temps réel, leur permettant de fournir des réponses actualisées et sourcées.
En bref
- Connecte les LLMs à des données fraîches externes
- Réduit drastiquement les hallucinations IA
- Architecture utilisée par Perplexity, Google AI Overviews
Pourquoi « RAG » compte en 2026
Le RAG est devenu l'architecture dominante en 2026 pour une raison simple : les utilisateurs exigent des réponses fiables et actuelles.
L'impact pour le GEO
Le RAG change fondamentalement les règles du jeu pour l'optimisation. Voici pourquoi :
1. La fraîcheur devient critique
Contrairement aux LLMs classiques qui se basent sur des données d'entraînement anciennes, les systèmes RAG recherchent activement le contenu récent. Mettre à jour votre contenu régulièrement n'est plus optionnel.
2. L'indexabilité détermine la citabilité
Si les crawlers ne peuvent pas accéder à votre contenu, les systèmes RAG ne peuvent pas le récupérer. L'accessibilité technique de votre site influence directement votre visibilité IA.
3. La structure facilite l'extraction
Les systèmes RAG extraient des passages spécifiques de vos pages. Un contenu bien structuré (headings, listes, définitions claires) sera plus facilement "découpé" et cité.
4. L'autorité reste primordiale
Même avec le RAG, les systèmes priorisent les sources autoritaires. Les signaux E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness) influencent quelles sources sont sélectionnées.
Définition complète
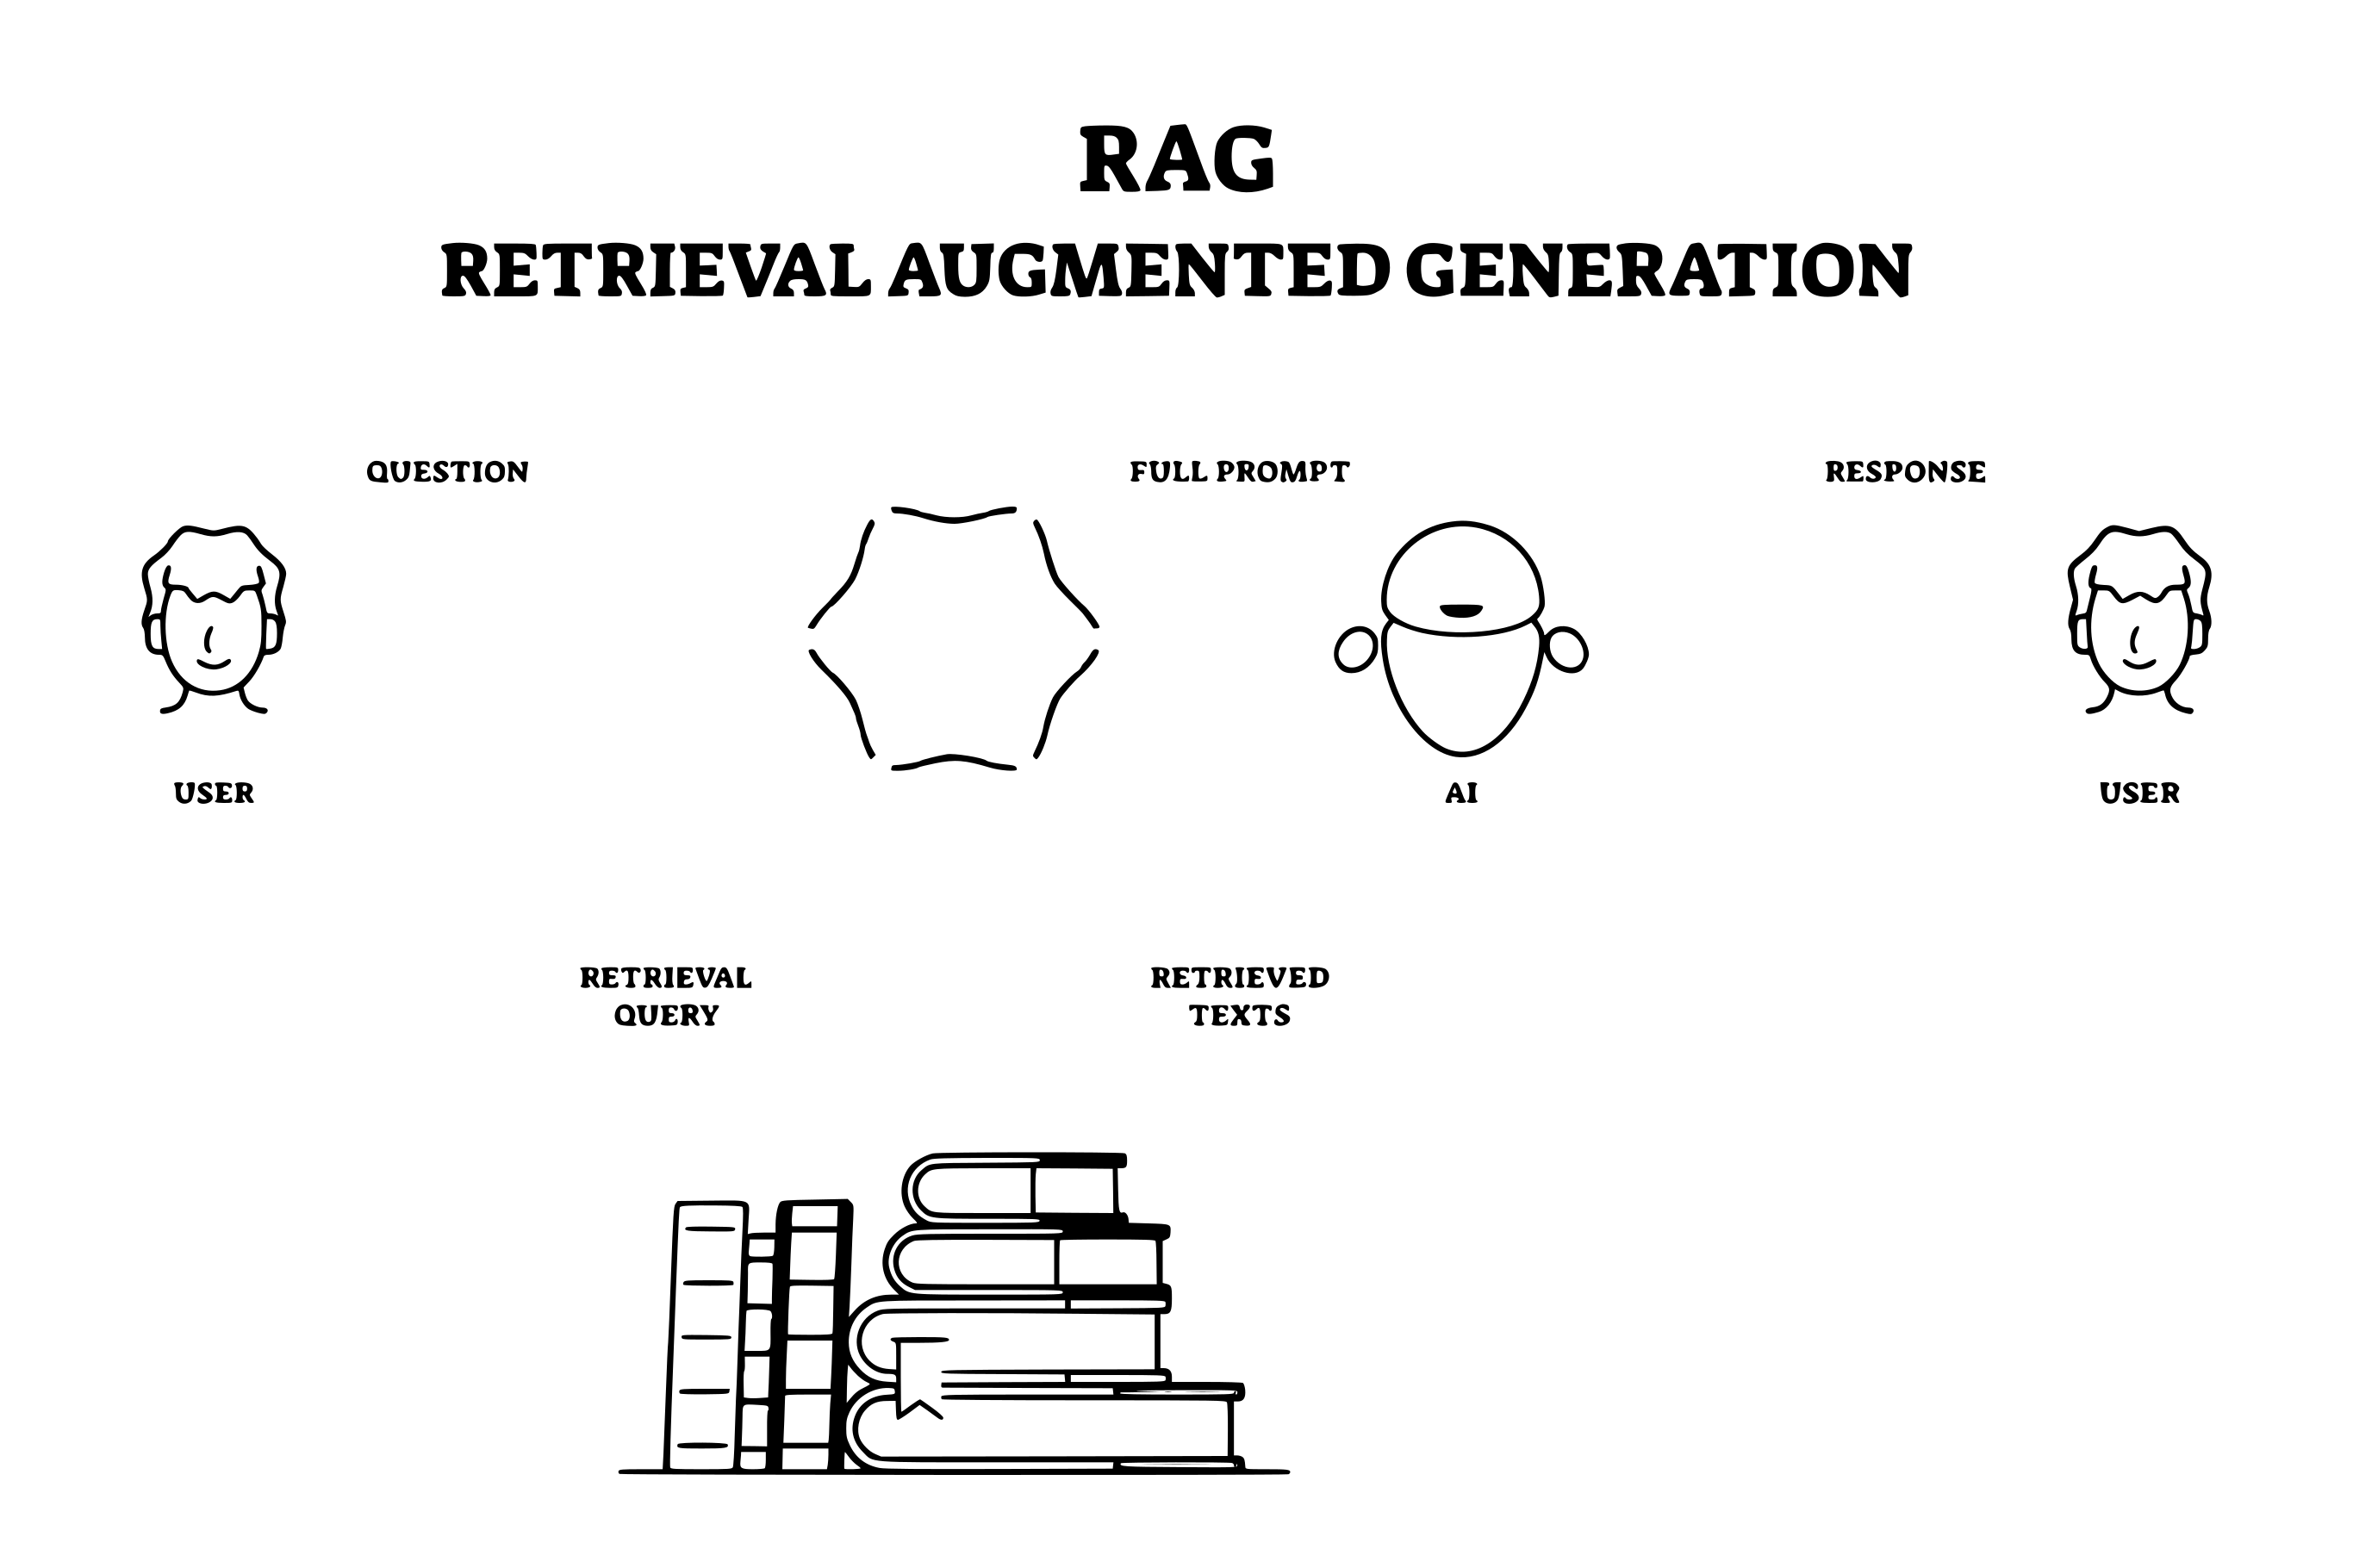
Le RAG (Retrieval-Augmented Generation) représente une révolution dans l'architecture des systèmes IA. Au lieu de se fier uniquement aux connaissances "figées" apprises pendant l'entraînement, un système RAG va chercher des informations pertinentes dans des sources externes avant de générer sa réponse.
Comment fonctionne le RAG
- Requête de l'utilisateur : L'utilisateur pose une question au système IA
- Phase de Retrieval : Le système recherche dans des bases de données, le web, ou des documents les informations les plus pertinentes
- Augmentation du Contexte : Les informations récupérées sont ajoutées au contexte du LLM
- Génération de la Réponse : Le LLM génère une réponse en s'appuyant sur ces données fraîches
Cette architecture résout deux problèmes majeurs des LLMs classiques :
- Les données obsolètes : Les LLMs sont entraînés sur des données à une date précise. GPT-4 ne "sait" rien de ce qui s'est passé après sa date de coupure. Le RAG permet d'accéder à l'information en temps réel.
- Les hallucinations : En ancrant les réponses dans des sources vérifiables, le RAG réduit considérablement le risque que l'IA "invente" des informations.
Le RAG dans l'écosystème actuel
- Perplexity AI : Le cas d'usage le plus visible. Perplexity combine un LLM avec une recherche web temps réel pour fournir des réponses sourcées avec des citations cliquables.
- Google AI Overviews : Google utilise une forme de RAG pour ses AI Overviews, combinant Gemini avec l'index de recherche.
- ChatGPT Browse : La fonctionnalité de navigation web de ChatGPT est une implémentation de RAG.
RAG vs fine-tuning : le comparatif
| Critère | Fine-Tuning | RAG (Retrieval-Augmented Generation) |
|---|---|---|
| Métaphore | Apprendre par cœur | Consulter un livre ouvert |
| Données | Figées à l'entraînement | Fraîches et temps réel |
| Coût | Élevé (réentraînement) | Modéré (infrastructure retrieval) |
| Hallucinations | Risque présent | Réduites (sources vérifiables) |
| Cas d'usage | Style, ton, domaine spécifique | Faits actuels, citations, recherche |
| Exemples | Chatbots de marque personnalisés | Perplexity, Google AI Overviews |
Ce qu’en fait Atyla
Atyla mesure votre présence dans les réponses des IA qui cherchent sur le web, comme Perplexity et, avec l’offre Growth, la réponse IA de Google.
Ce qu’Atyla vous montre
- Les liens cités : pour chaque question, les pages que l’IA cite comme sources, chez vous et chez vos concurrents.
- Les réponses réelles : le texte exact de chaque réponse, horodaté, avec votre marque surlignée.
- L’audit de vos pages : chaque semaine, ce qui empêche les IA de comprendre ou de citer une page, et la correction à faire.
- L’effet de vos corrections : chaque action faite est comparée avant et après, sur les questions qu’elle vise.
Pourquoi c’est utile
Les IA qui citent leurs sources affichent des liens cliquables : être cité peut amener des visites, que vous retrouvez dans Google Analytics 4.
Questions fréquentes
Quelle est la différence entre RAG et Fine-Tuning ?
Le RAG connecte l'IA à des données externes (comme consulter un livre ouvert), tandis que le Fine-Tuning réentraîne le modèle (comme apprendre par cœur). Le RAG permet des données fraîches avec citations, le Fine-Tuning personnalise le style et le domaine.
Pourquoi le RAG réduit-il les hallucinations ?
Le RAG ancre les réponses dans des sources vérifiables récupérées en temps réel. Au lieu d'inventer, l'IA cite des informations existantes. C'est pourquoi les systèmes RAG comme Perplexity fournissent des citations avec leurs réponses.
Comment optimiser mon contenu pour les systèmes RAG ?
Pour être cité par les systèmes RAG : 1) Assurez-vous que votre site est crawlable par les bots IA, 2) Structurez votre contenu clairement (headings, listes), 3) Mettez à jour régulièrement, 4) Incluez des faits vérifiables et des données originales.
Perplexity utilise-t-il le RAG ?
Oui, Perplexity est l'exemple le plus connu d'architecture RAG grand public. Pour chaque requête, il recherche le web en temps réel, sélectionne les sources pertinentes, et génère une réponse avec des citations cliquables.